Was ist ein Runbook? Definition, Vorlage + Beispiel (2026)
Ein Runbook ist eine Schritt-für-Schritt-Anleitung für genau eine betriebliche Aufgabe oder einen Alert, etwa wenn ein hängender Dienst neu gestartet oder ein Zertifikat erneuert werden muss. Es nennt den Auslöser, die genauen Befehle und die erwartete Ausgabe jedes Schritts. Außerdem steht darin, wie du den Fix bestätigst, zurückrollst und eskalierst, damit jeder in der Rufbereitschaft zum selben Ergebnis kommt.
Du suchst vor deiner nächsten Rufbereitschaft nach „Was ist ein Runbook“? Kopier dir unten die Vorlage und das ausgefüllte Beispiel.
Was ist ein Runbook?
Die schlichteste Definition kommt von AWS: Ein Runbook ist „ein dokumentierter Prozess für das Erreichen eines bestimmten Ergebnisses“, in der einfachsten Form eine Checkliste. Ein Runbook deckt genau eine Aufgabe oder einen Alert ab: einen hängenden Dienst neu starten, ein TLS-Zertifikat erneuern, ein Failover der Datenbank auslösen oder einen geleakten API-Key rotieren.
Aufgeschriebene Schritte sorgen dafür, dass alle in der Rufbereitschaft zum selben Ergebnis kommen, dass der eine Experte seltener alarmiert wird und dass Systeme schneller wieder laufen. Googles SRE-Buch schreibt einem Playbook gegenüber reinem Improvisieren eine etwa dreifache Verbesserung der MTTR zu.
Als Prozessdokumentation für den Systembetrieb liegen Runbooks in einer RUNBOOK.md neben dem Code oder auf einer Wikiseite, verlinkt aus dem Alert und der README. In Azure Automation und AWS Systems Manager ist ein Runbook das Skript oder Dokument, das die Schritte ausführt.
Runbook vs. Playbook vs. SOP
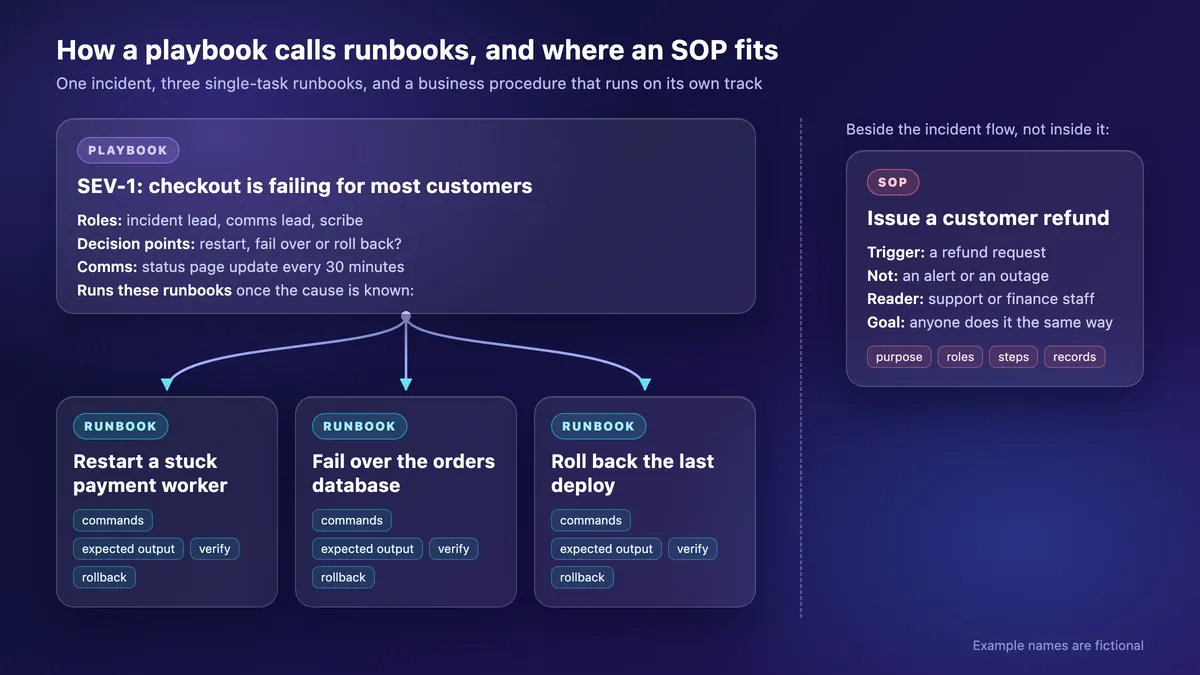
Ein Runbook erledigt eine einzelne Aufgabe, ein Playbook steuert einen ganzen Incident, und eine SOP macht eine Geschäftsaufgabe wiederholbar.
| Runbook | Playbook | SOP | |
|---|---|---|---|
| Beantwortet die Frage | Wie erledige ich genau diese eine Aufgabe? | Wie steuern wir diesen Incident oder diese Untersuchung? | Wie erledigt jeder diese Geschäftsaufgabe auf dieselbe Weise? |
| Zielgruppe | On-Call-Engineer | Incident-Lead, Responder | Alle Mitarbeitenden |
| Auslöser | Alert, Ticket oder Zeitplan | Ausgerufener Incident | Erstattungsantrag, Neueinstellung |
| Inhalt | Befehle, erwartete Ausgabe, Prüfung, Rollback | Rollen, Kommunikation, Entscheidungen, auszuführende Runbooks | Zweck, Rollen, Schritte, Nachweise |
| Automatisierung | Oft | Teilweise (geskriptete Diagnose; in SOAR-Tools voll automatisiert) | Selten |
| Beispiel | Einen hängenden Payment-Worker neu starten | SEV-1-Ausfall im Checkout | Einem Kunden Geld erstatten |
Die Begriffe überschneiden sich. AWS nutzt „Playbook“ für die Suche nach der Ursache und „Runbook“ für die Behebung (OPS07-BP04), während die SRE-Teams von Google ihre Dokus für einzelne Alerts als Playbooks bezeichnen. Leg dich auf eine Bedeutung fest und schreib sie in den Index deiner Doku.
Für Erstattungen, Onboarding und andere Geschäftsaufgaben brauchst du stattdessen eine SOP-Vorlage.
Runbook-Vorlage (zum Kopieren)
Füg sie in ein Wiki oder eine RUNBOOK.md ein. Confluence, Notion, Google Docs und Word funktionieren alle.
# Runbook: [Alert-Name oder Aufgabe, genau so formuliert wie im Alert]
Owner: [Team oder Rotation] · Zuletzt geprüft: [JJJJ-MM-TT] · Gilt für: [Dienst, Umgebung, Version]

## Wann du dieses Runbook brauchst
Auslöser: "[genauer Alert-Text, Ticket-Typ oder Zeitplan]"
Auswirkung auf Nutzer: [was Kunden oder Mitarbeitende bemerken] · Schweregrad: [SEV-Stufe]

## Bevor du anfängst
- Zugriff: [Cluster-Kontext, Konsolenrolle, Break-Glass-Konto]
- Links: [Dashboard] · [Logs] · [Statusseite des Anbieters]

## Diagnose (nur lesend)
1. [Befehl oder Schritt in der Konsole]
   Erwartet: [Ausgabe oder Screenshot des gesunden Zustands]

## Beheben
2. [Befehl]
   Erwartet: [Ausgabe]

## Prüfen
3. [Metrik oder Check, der die Wiederherstellung belegt]

## Zurückrollen oder stoppen
- Wenn [Bedingung]: [Befehl], dann eskalieren.

## Eskalieren
- Nach [N] Minuten immer noch fehlerhaft oder [Bedingung]: [Rotation] alarmieren.

## Änderungsprotokoll
- [JJJJ-MM-TT] [wer] [was sich geändert hat]- Der genaue Alert-Text macht die Seite auffindbar. Kopier ihn mit dem kostenlosen Tool zum Extrahieren von Text aus Bildern aus einem Screenshot des Alerts.
- Owner und Zuletzt geprüft zeigen, wer die Seite pflegt und wie weit du ihr trauen kannst. Wer das System verantwortet, verantwortet auch seine interne Dokumentation.
- Nur lesende Schritte stehen am Anfang, damit ein übermüdeter Leser erst hinschaut, bevor er etwas anfasst.
Runbook-Beispiel: einen hängenden Payment-Worker neu starten
Die Vorlage, ausgefüllt für einen fiktiven Kubernetes-Dienst (erfundene Namen, echte kubectl-Befehle):
# Runbook: PaymentsQueueBacklog
Owner: Payments-Rufbereitschaft · Zuletzt geprüft: 2026-11-03 · Gilt für: payment-worker, prod

## Wann du dieses Runbook brauchst
Auslöser: "PaymentsQueueBacklog: payments-jobs queue depth above 5,000 for 10 minutes"
Auswirkung auf Nutzer: Bestellungen hängen in "Payment pending" fest (autorisiert, nicht eingezogen) · Schweregrad: SEV-2

## Bevor du anfängst
- kubectl-Kontext für prod, Queue-Dashboard, Statusseite des Anbieters

## Diagnose (nur lesend)
1. kubectl -n payments get pods -l app=payment-worker
   Erwartet: alle Pods im Status Running, RESTARTS steigt nicht
2. kubectl -n payments logs -l app=payment-worker --prefix --since=15m --tail=50
   Erwartet: Zeilen von jedem Pod (logs deployment/payment-worker liest nur einen); achte auf "db pool exhausted"
3. Meldet die Statusseite des Anbieters eine Störung? Nicht neu starten. Eskalieren.

## Beheben
4. kubectl -n payments rollout restart deployment/payment-worker
5. kubectl -n payments rollout status deployment/payment-worker --timeout=5m
   Erwartet: deployment "payment-worker" successfully rolled out

## Prüfen
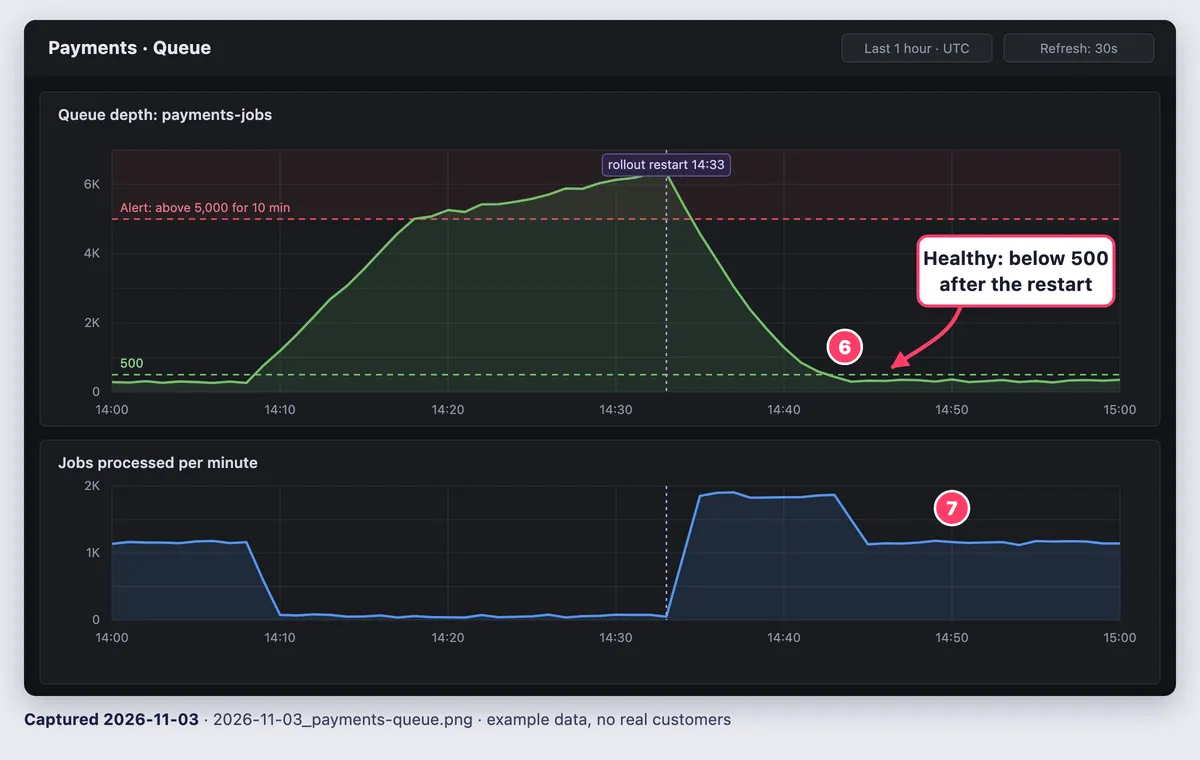
6. Queue-Länge innerhalb von 10 Minuten unter 500
7. Jobs pro Minute wieder auf Normalniveau; 5 Minuten lang keine neuen Fehler im Log
8. Smoke-Test nach dem Deployment ausführen; Ergebnisse im Incident-Channel posten

## Zurückrollen oder stoppen
- Ein Neustart ändert keinen Code: Es gibt nichts zurückzunehmen.
- Hängt direkt nach einem Deployment fest: kubectl -n payments rollout history deployment/payment-worker,
  dann kubectl -n payments rollout undo deployment/payment-worker --to-revision=[N]
  (ein undo ohne Revision macht nur den Neustart rückgängig)
- Zahlungen doppelt eingezogen: kubectl -n payments scale deployment/payment-worker --replicas=0,
  dann sofort die Payments-Rufbereitschaft alarmieren.

## Eskalieren
- Queue wächst 15 Minuten nach dem Neustart weiter oder es gibt Datenbankfehler: data-platform-primary alarmieren.
Prüf die Schritte 6 und 7 gegen einen annotierten Screenshot des gesunden Zustands. Das kostenlose Tool zur Bildannotation setzt Pfeile, Formen und ein gefülltes Rechteck direkt im Browser, ganz ohne Installation.
Die Rollback-Schritte stammen oft aus dem Rollback-Plan in deinem Software-Design-Dokument. Echte öffentliche Runbooks findest du bei GitLab (#7 in diesen Beispielen für technische Dokumentation) und in den Runbooks von kube-prometheus.

Genug von langweiligen Screenshots? Probier ScreenSnap Pro.
Schöne Hintergründe, professionelle Anmerkungen, GIF-Aufnahme und sofortiges Teilen in der Cloud, alles in einer App. Einmal 39 $ zahlen, für immer besitzen.
Preis und Funktionen ansehenArten von Runbooks: manuell, teilautomatisiert und automatisiert
Runbook-Automatisierung gibt es in drei Stufen:
- Manuell: Ein Mensch liest jeden Schritt und führt ihn aus.
- Teilautomatisiert: Das Dokument startet Skripte oder Jobs per Klick (Rundeck, Azure Automation oder AWS Systems Manager), und ein Mensch gibt riskante Schritte frei.
- Vollautomatisiert: Ein Alert löst den Fix aus. Das Runbook bleibt als Spezifikation und Rückfallebene bestehen.
AWS rät, einen manuellen Prozess erst zu erproben, bevor du ihn in Code gießt. Automatisiere zuerst kurze, häufige Runbooks und lass Ermessensentscheidungen (Failover? Incident ausrufen?) bei einem Menschen. KI-Agenten brauchen dasselbe wie ein übermüdeter Mensch: genaue Befehle, erwartete Ausgaben und Abbruchbedingungen.
So erstellst du ein Runbook, das auch um 3 Uhr nachts funktioniert
Bau es auf echten Alarmierungen auf, teste es mit jemand anderem und halte es aktuell.
- Fang mit dem an, was am häufigsten alarmiert: die Top-Alerts und die Fixes aus den letzten Postmortems.
- Füll die Vorlage aus: zuerst nur lesende Schritte, Befehle als Text (nie nur als Bild), nach jedem Schritt die erwartete Ausgabe.
- Ergänze die Ausstiege: Prüfen (etwa mit einem Smoke-Test nach dem Deployment), Zurückrollen und Eskalieren.
- Verlinke es im Alert (in Grafana zum Beispiel über die Annotation
runbook_url) und benenne es nach dem Alert. - Teste es in einer Übung: Jemand anderes führt es aus. Korrigiere jeden Schritt, an dem die Person ins Stocken gerät, und aktualisiere „Zuletzt geprüft“, so wie es der betriebliche Abnahmetest vor dem Go-live tut.
Bilder für Schritt 2: Zeig nur, was Text nicht zeigen kann. Das sind Klickpfade, für die es keinen CLI-Befehl gibt, und das gesunde Panel, zugeschnitten, mit Zählern passend zu den Schrittnummern und einem Callout für den Schwellenwert. Nimm den Fix als asciinema-Cast oder als GIF unter 30 Sekunden auf (Anleitung zum Aufnehmen von Terminal-Sitzungen).
Leg deckende Kästen über Konto-IDs, Tokens, Connection Strings und E-Mail-Adressen, denn Weichzeichnen und Verpixeln lassen sich rückgängig machen. Nimm lieber ein Staging-Konto und halte dich an die üblichen Regeln für Screenshots in der Dokumentation.
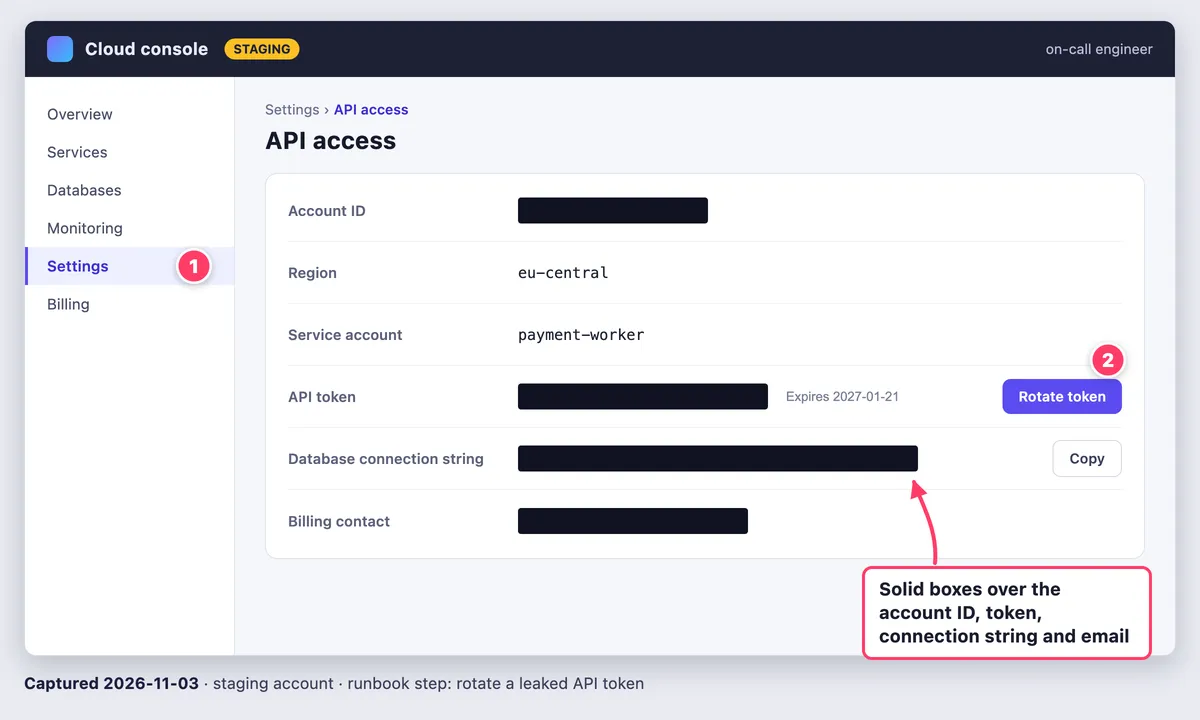
Halte die Bilder aktuell (Schritt 5): Schreib das Datum in Dateiname und Bildunterschrift jeder Aufnahme (2026-11-03_payments-queue.png, „Aufgenommen am 2026-11-03“) und mach sie bei jeder Übung und jeder UI-Änderung neu. Laut Googles SRE-Workbook veralten Details in Playbooks so schnell, wie sich die Produktion ändert. Leg die Bilddateien bei der Doku ab und nutze nie Share-Links dafür.
Für ein einzelnes Panel reichen die eingebauten Tools: auf dem Mac die Bildschirmfoto-App mit Markierungen, unter Windows das Snipping Tool, das auch Text kopiert und E-Mail-Adressen sowie Telefonnummern schwärzt. ScreenSnap Pro bündelt den ganzen Ablauf in einer App: nummerierte Zähler und Callouts, ein deckend gefülltes Rechteck für Secrets und eine angepinnte Aufnahme des gesunden Panels neben deinem Terminal. Videoaufnahmen kürzt du im eingebauten Editor und exportierst sie als MP4 oder GIF.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem Runbook und einer SOP?
Ein Runbook deckt eine einzelne Systemaufgabe oder einen Alert ab, mit Befehlen und erwarteter Ausgabe. Eine SOP legt die Schritte für eine Geschäftsaufgabe fest, etwa für Erstattungen, damit jeder sie wiederholen kann.
Was sind Playbooks?
Ein Playbook steuert eine größere Reaktion: Rollen, Kommunikation, Entscheidungen und die Runbooks, die ausgeführt werden sollen. In Ansible bedeutet Playbook etwas anderes: eine YAML-Datei mit Tasks.
Was ist ein anderes Wort für Runbook?
Run Book, Betriebshandbuch, Ops-Leitfaden oder Verfahrensanweisung. Die SRE-Teams von Google nennen es Playbook.
Was ist ein Runbook in der Softwareentwicklung?
In DevOps- und SRE-Teams ist ein Runbook die Anleitung, der On-Call-Engineers für einen Dienst oder Alert folgen. Es liegt neben dem Code oder ist aus dem Alert verlinkt.
Was ist ein Runbook in Azure?
In Azure Automation ist ein Runbook der Code selbst: ein PowerShell- oder Python-Skript oder ein grafischer Workflow, von Hand oder nach Zeitplan gestartet. PowerShell-Runbooks lassen sich auch über einen Webhook oder einen Alert aus Azure Monitor starten.
Schreib noch diese Woche dein erstes Runbook
Wenn das Aufnehmen und Markieren von Screenshots und Bildschirmaufnahmen für deine Runbooks der langsame Teil ist, hilft ScreenSnap Pro. Es ist ein einmaliger Kauf für 39 $: 1 Lizenz für 2 Computer (2 Aktivierungen, Mac oder Windows). Zu den Preisen.

Morgan
Indie DeveloperIndie developer, founder of ScreenSnap Pro. A decade of shipping consumer Mac apps and developer tools. Read full bio
@m_0_r_g_a_n_